AFARAG
RAG local y agéntico para el conocimiento de su empresa
Usted ya posee los datos más valiosos de su sector: miles de PDF, contratos, ofertas, informes, planos, correos y registros de bases de datos. AfaRAG convierte ese archivo disperso en un sistema de IA capaz de razonar, que responde con su propio conocimiento, cita cada fuente y nunca sale de su edificio.
Su conocimiento ya está ahí
Solo que es inutilizable. Repartido entre servidores de archivos, buzones de correo, sistemas ERP y SharePoint; imposible de buscar, sin documentar y encerrado en la cabeza de unos pocos compañeros.
Buscar en lugar de trabajar
Los empleados dedican horas cada semana a localizar la versión correcta de un documento, la última oferta comparable o una especificación técnica de 2019.
El conocimiento se va por la puerta
Cuando un compañero con experiencia se jubila o cambia de empresa, décadas de conocimiento de proyectos se van con él, aunque todos los documentos sigan en el servidor.
La IA pública no es una opción
Contratos, datos personales, planos constructivos y cálculos nunca deben subirse a un servicio en la nube estadounidense. Compliance bloquea el proyecto antes de empezar.
Cómo funciona AfaRAG
Un pipeline de recuperación completo más una capa de razonamiento agéntico, con todos y cada uno de los componentes ejecutándose dentro de su propia infraestructura.
INDEXACIÓN · se ejecuta en segundo plano cuando cambian los documentos
Sus datos
archivos · correo · ERP · DMS
AfaRAG se conecta a los sistemas que ya usa y detecta los cambios. Nada se copia a la nube.
Lectura y OCR
maquetación · tablas · escaneos
Cada documento se lee como lo leería una persona: se conservan títulos, tablas y números de página, y las páginas escaneadas pasan por un OCR local.
Fragmentar y enriquecer
secciones · sello de página
El texto se divide según su propia estructura. Cada fragmento conoce su ruta de sección, su página y su carpeta, así una tabla de números sabe a qué pertenece.
Vectorizar
vectores densos + dispersos
Un modelo de embeddings multilingüe convierte cada fragmento en un vector de significado, y junto a él se guarda un vector de palabras clave para términos exactos y referencias.
Extraer entidades
empresas · personas · valores
Se extraen empresas, personas, proyectos, importes y fechas, se unifican sus variantes de escritura y cada relación conserva el archivo y la página que la prueban.
Índice híbrido
vectores + palabras clave
Un único almacén vectorial guarda vectores densos y dispersos de millones de fragmentos, con filtros por proyecto, tipo de documento, fecha y permisos.
Grafo de conocimiento
entidades y relaciones
Quién trabajó con quién, en qué proyecto y dónde consta. El grafo responde preguntas de relaciones que la búsqueda de texto no puede.
Almacén de hechos
registros estructurados
Contactos, facturas, ofertas y resultados de ensayos se guardan como registros estructurados, para que recuentos, sumas y comparaciones se calculen en lugar de adivinarse.
Modelos locales
todo en su servidor GPU
Todos los modelos se ejecutan en su propio hardware. Nada llama a una API externa y cada modelo puede sustituirse cuando aparezca uno abierto mejor.
PREGUNTA → RESPUESTA · en cada consulta, en segundos
Pregunta
chat · voz · API
Pregunte con sus palabras y en su idioma: escribiendo, hablando, con una imagen adjunta o desde otro sistema a través de la API.
Reformular y enrutar
intención → herramientas
Un modelo local pequeño elimina el saludo, corrige nombres, convierte la pregunta en una frase de búsqueda y decide qué herramientas necesita.
Recuperar
hasta 7 vías, fusionadas
Búsqueda semántica, por palabras clave, identificadores exactos, rutas de archivo, grafo y hechos se ejecutan en paralelo y se fusionan en los 100 mejores candidatos.
Reordenar y filtrar
100 → ~8 pasajes
Un cross-encoder lee la pregunta y cada pasaje juntos. Los pasajes débiles se descartan y los que quedan se amplían a su tabla o sección completa.
Generar
LLM local · cita fuentes
El LLM local razona solo sobre los pasajes seleccionados y redacta la respuesta en el idioma de la pregunta, citando cada afirmación.
Verificar
cifras · nombres · archivos
Cada cifra, nombre y nombre de archivo de la respuesta se comprueba con las fuentes. Lo que no aparece en ellas se señala bajo la respuesta.
Respuesta + fuentes
citas con página exacta
Recibe la respuesta con los documentos y páginas de los que procede, a un clic del archivo original.
↻ Bucle del agente: ¿pocas evidencias? Planificar, buscar de nuevo, usar herramientas
Visión esquemática: del archivo en bruto a una respuesta verificada con citas de las fuentes, sin que un solo byte salga de su red.
DEMO EN VIVO
Vea cómo piensa AfaRAG
Una sesión simulada con los pasos reales del pipeline: el agente reformula la pregunta, elige sus herramientas, busca, reordena, comprueba cada cifra y cada nombre con las fuentes y solo entonces redacta la respuesta. A la derecha, el grafo de conocimiento ilumina las entidades que va tocando.
Grafo de conocimiento
Arrastre los nodos. Pase el cursor o toque uno para ver sus conexiones y los documentos que las respaldan.
Simulación con datos ficticios. Los tiempos están acortados para la demo.
Todos los formatos, estructurados o no
No nos limitamos a extraer texto. Reconocemos la maquetación, las tablas, los encabezados, las notas al pie, las imágenes incrustadas y las páginas escaneadas, de modo que la IA entiende el documento igual que lo lee una persona.
¿Un formato propietario o específico de su sector? Desarrollamos el parser para él.
Mucho más que buscar documentos
Un RAG clásico recupera un fragmento. Un RAG agéntico planifica, busca varias veces, usa herramientas, verifica su propio resultado y actúa.
Se conecta con lo que ya utiliza
Su RAG no vive en una isla. Mediante servidores MCP y conectores dedicados alcanza sus sistemas operativos, en modo solo lectura o con acciones de escritura, exactamente como usted lo defina.
¿Le falta algo? Cualquier cosa con una API, o incluso un simple recurso compartido, se puede conectar.
Nosotros ponemos el hardware
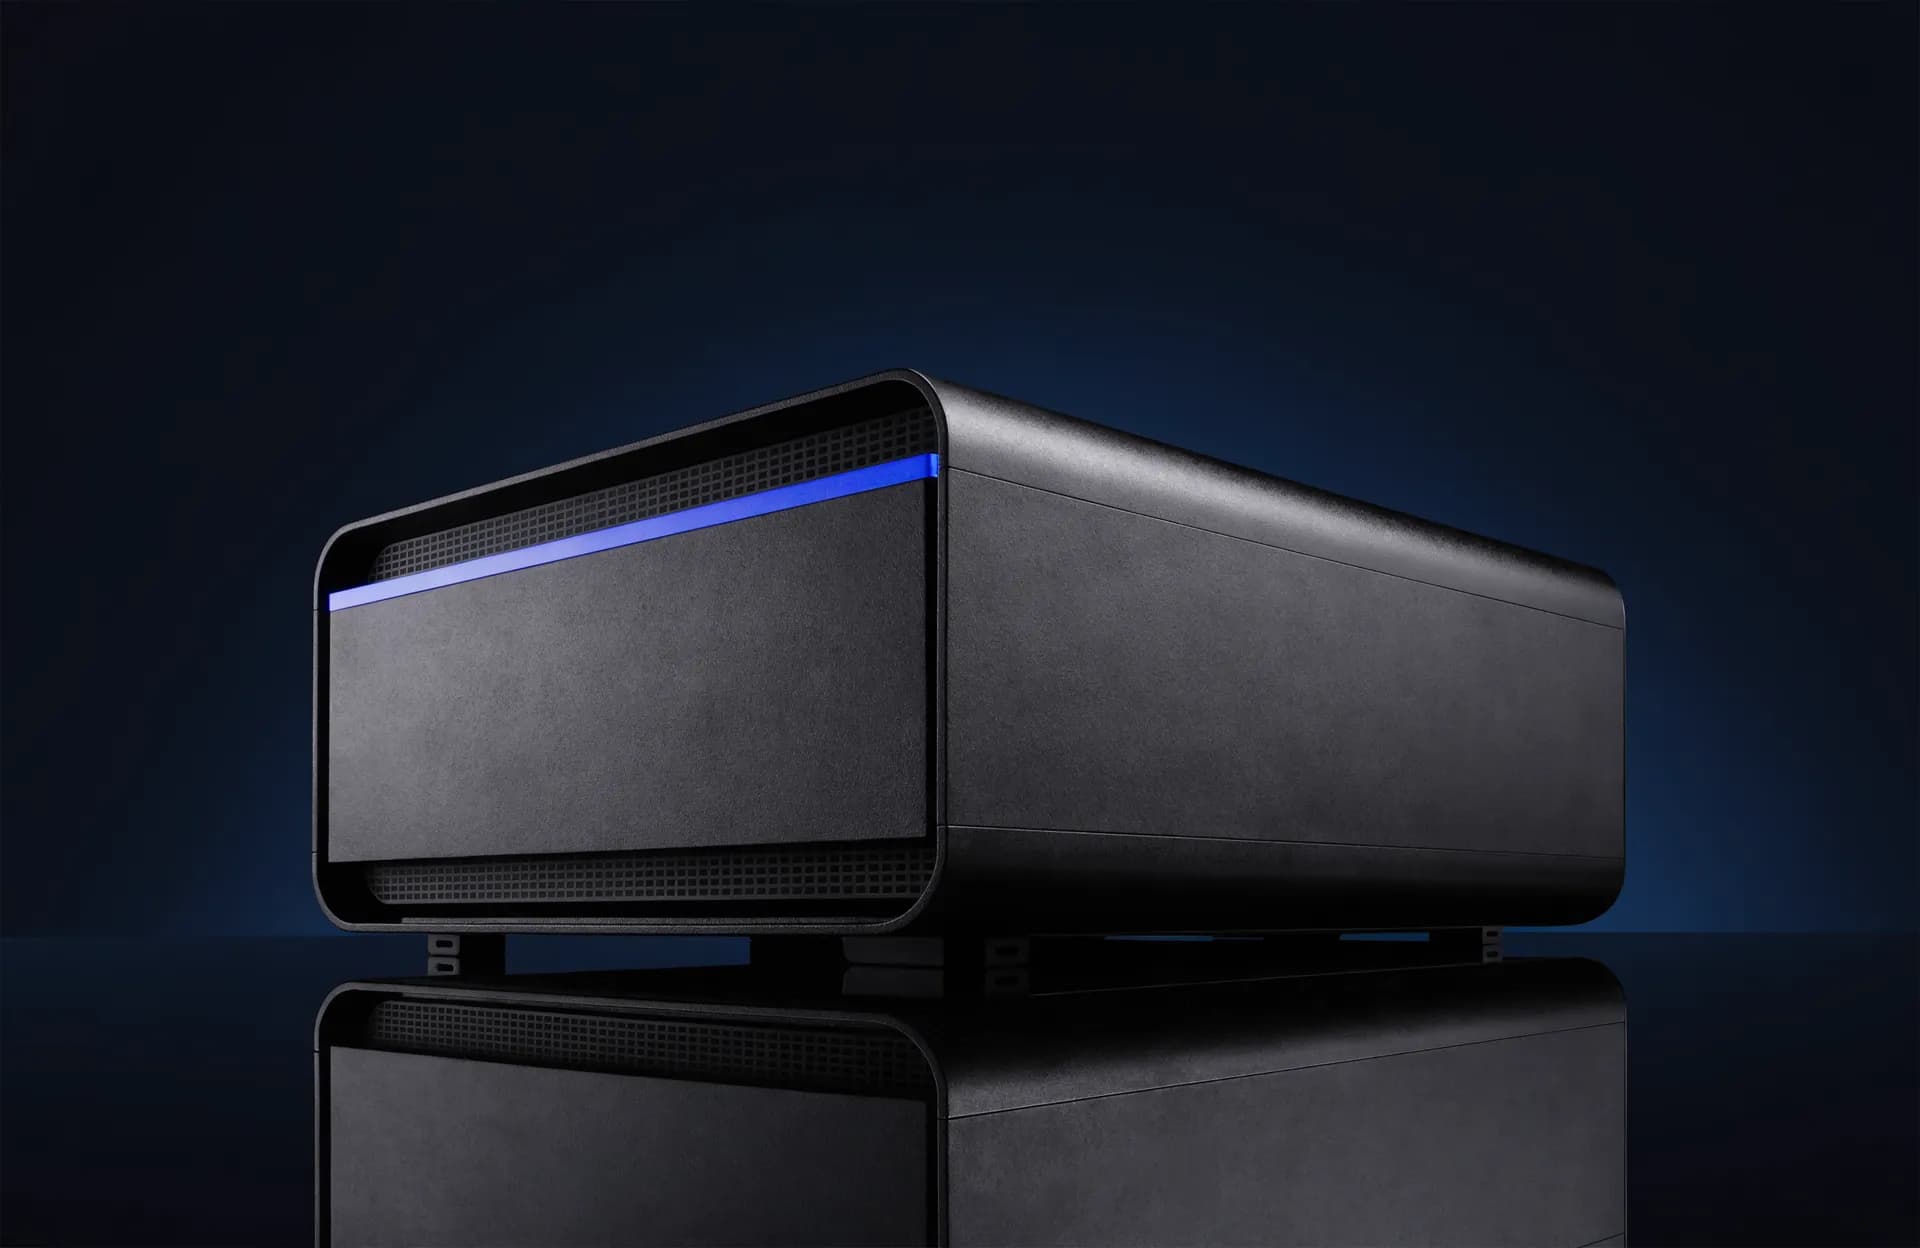
Un RAG local necesita cómputo con GPU. Usted no tiene que comprarlo, dimensionarlo ni configurarlo. Entregamos un appliance listo para funcionar, instalado y ajustado a su volumen de datos y a su número de usuarios.
Dimensionado a su medida
Medimos su volumen documental, su número de usuarios y sus expectativas de tiempo de respuesta, y especificamos la configuración exacta de GPU, RAM y almacenamiento, sin sobredimensionar nada.
Entregado e instalado
Servidor de rack o appliance de sobremesa, entregado en sus instalaciones, montado, conectado a su red y puesto en marcha por nuestros ingenieros.
Mantenido y escalable
Monitorización, actualizaciones y mejoras de modelo incluidas bajo demanda. ¿Crece el equipo o el volumen de datos? Se añaden nodos GPU adicionales sin paradas.
- Appliance de equipo: para departamentos de hasta unos 25 usuarios y cientos de miles de páginas
- Servidor de rack empresarial: para uso en toda la empresa, multi-GPU, terabytes de documentos
- Clúster enterprise: varios cientos de usuarios simultáneos, alta disponibilidad, nodos redundantes
- Variante air-gapped: totalmente aislada, para defensa, sanidad e infraestructuras críticas
100 % RGPD por arquitectura
No es una promesa en las condiciones del servicio, sino un hecho técnico: no existe ninguna conexión saliente para procesar sus datos.
Dónde AfaRAG marca la diferencia
De la primera llamada al sistema en marcha
Taller de análisis
Analizamos sus fuentes de datos, casos de uso, grupos de usuarios y requisitos de seguridad, y definimos objetivos medibles.
Prueba de concepto
Un conjunto limitado de datos sobre hardware real. Verá respuestas reales sobre sus propios documentos antes de comprometerse con el despliegue.
Hardware e instalación
Entregamos e instalamos el appliance, conectamos sus fuentes e indexamos su archivo, terabytes incluidos.
Agentes e integraciones
Las skills, las conexiones MCP, la integración con el correo y los flujos de trabajo se construyen en torno a cómo trabaja realmente su equipo.
Despliegue y soporte
Formación, onboarding, monitorización y mejora continua, con un socio austriaco al que puede llamar.
Nuestro socio oficial
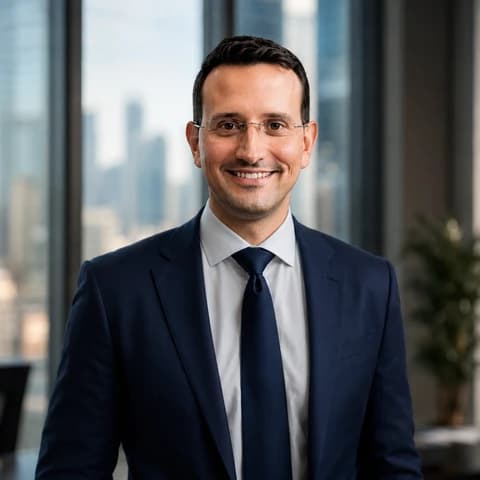
Alan Zettelmann, MBA, MBI, IMBB
Asesor de AfaTech GmbH
Experto en innovación corporativa, gestión del cambio y adopción de IA
Alan Zettelmann es un experimentado estratega de innovación corporativa y transformación, con una amplia trayectoria en gestión de la innovación, desarrollo organizacional y gestión del cambio en grandes empresas. A través de cargos de liderazgo en organizaciones internacionales como ANDRITZ Hydro, AVL y Know-Center, ha contribuido al desarrollo e implementación de estrategias de innovación, nuevos productos e iniciativas de transformación organizacional. En AfaTech, Alan asesora en innovación corporativa, gestión del cambio y adopción exitosa de inteligencia artificial dentro de organizaciones consolidadas. Su enfoque consiste en conectar la tecnología con necesidades empresariales reales y garantizar que las iniciativas de IA sean prácticas, escalables y se integren de forma sostenible en los procesos existentes.
Preguntas frecuentes
¿Listo para liberar el conocimiento de su empresa ?
Cuéntenos qué datos tiene y cuál es su caso de uso. Recibirá una valoración honesta, un concepto técnico y una oferta concreta con hardware incluido, de un equipo de ingeniería en Graz (Austria).