AFARAG
RAG agentico locale per la conoscenza della vostra azienda
Possedete già i dati più preziosi del vostro settore: migliaia di PDF, contratti, offerte, report, disegni, e-mail e record di database. AfaRAG trasforma questo archivio frammentato in un sistema di IA capace di ragionare, che risponde con la vostra conoscenza, cita ogni fonte e non lascia mai la vostra sede.
La vostra conoscenza esiste già
Solo che è inutilizzabile. Sparsa tra file server, caselle di posta, sistemi ERP e SharePoint, impossibile da cercare, non documentata e chiusa nella testa di pochi colleghi.
Cercare invece di lavorare
I collaboratori passano ore ogni settimana a cercare la versione giusta di un documento, l'ultima offerta comparabile o una specifica tecnica del 2019.
La conoscenza se ne va
Quando i colleghi più esperti vanno in pensione o cambiano lavoro, decenni di know-how di progetto se ne vanno con loro, anche se ogni documento è ancora sul server.
L'IA pubblica non è un'opzione
Contratti, dati personali, progetti edilizi e calcoli non devono mai essere caricati su un servizio cloud statunitense. La compliance blocca il progetto prima ancora che inizi.
Come funziona AfaRAG
Una pipeline di retrieval completa più un livello di ragionamento agentico, e ogni singolo componente gira all'interno della vostra infrastruttura.
INDICIZZAZIONE · gira in background ogni volta che i documenti cambiano
I vostri dati
file · e-mail · ERP · DMS
AfaRAG si collega ai sistemi che usate già e ne rileva le modifiche. Nulla viene copiato nel cloud.
Lettura e OCR
layout · tabelle · scansioni
Ogni documento viene letto come lo leggerebbe una persona: titoli, tabelle e numeri di pagina restano, e le pagine scansionate passano da un OCR locale.
Segmentare e arricchire
sezioni · timbro di pagina
Il testo viene diviso seguendo la sua struttura. Ogni segmento conosce percorso di sezione, pagina e cartella, così anche una tabella di soli numeri sa a cosa appartiene.
Vettorizzare
vettori densi + sparsi
Un modello di embedding multilingue trasforma ogni segmento in un vettore di significato, e accanto viene salvato un vettore di parole chiave per termini esatti e codici.
Estrarre entità
aziende · persone · valori
Aziende, persone, progetti, importi e date vengono estratti e unificati tra le varie grafie, e ogni relazione conserva il file e la pagina che la provano.
Indice ibrido
vettori + parole chiave
Un unico archivio vettoriale contiene vettori densi e sparsi per milioni di segmenti, con filtri per progetto, tipo di documento, data e permessi.
Grafo della conoscenza
entità e relazioni
Chi ha lavorato con chi, su quale progetto e dove è documentato. Il grafo risponde a domande sulle relazioni che la sola ricerca testuale non può.
Archivio dei fatti
record strutturati
Contatti, fatture, offerte e risultati di prova sono salvati come record strutturati, così conteggi, somme e confronti vengono calcolati e non indovinati.
Modelli locali
tutto sul vostro server GPU
Ogni modello gira sul vostro hardware. Nulla chiama un'API esterna e ogni modello può essere sostituito quando ne esce uno aperto migliore.
DOMANDA → RISPOSTA · a ogni richiesta, in pochi secondi
Domanda
chat · voce · API
Chiedete con parole vostre e nella vostra lingua: scrivendo, parlando, allegando un'immagine o da un altro sistema tramite API.
Riformulare e instradare
intento → strumenti
Un piccolo modello locale toglie i convenevoli, corregge i nomi, trasforma la domanda in una frase di ricerca e decide quali strumenti servono.
Recuperare
fino a 7 canali, fusi
Ricerca semantica, per parole chiave, codici esatti, percorsi di file, grafo e fatti girano in parallelo e vengono fusi nei 100 migliori candidati.
Riordinare e filtrare
100 → ~8 passaggi
Un cross-encoder legge insieme la domanda e ogni passaggio. I passaggi deboli vengono scartati, gli altri estesi alla tabella o sezione completa.
Generare
LLM locale · cita le fonti
L'LLM locale ragiona solo sui passaggi selezionati e scrive la risposta nella lingua della domanda, citando ogni affermazione.
Verificare
cifre · nomi · file
Ogni cifra, nome e nome di file della risposta viene controllato sulle fonti. Ciò che non vi compare viene segnalato sotto la risposta.
Risposta + fonti
citazioni con pagina
Ricevete la risposta con i documenti e le pagine da cui proviene, a un clic dal file originale.
↻ Ciclo dell'agente: prove insufficienti? Pianificare, cercare di nuovo, usare strumenti
Panoramica schematica: dai file grezzi a una risposta verificata con citazione delle fonti, senza che un solo byte lasci la vostra rete.
DEMO LIVE
Guardate AfaRAG ragionare
Una sessione simulata con i passaggi reali della pipeline: l'agente riformula la domanda, sceglie gli strumenti, cerca, riordina, verifica ogni cifra e ogni nome sulle fonti e solo allora scrive la risposta. A destra, il grafo della conoscenza illumina le entità che tocca.
Grafo della conoscenza
Trascinate i nodi. Passate il mouse o toccate un nodo per vederne i collegamenti e i documenti che li provano.
Simulazione con dati fittizi. I tempi sono accorciati per la demo.
Ogni formato di file, strutturato o no
Non ci limitiamo a estrarre il testo. Layout, tabelle, titoli, note a piè di pagina, immagini incorporate e pagine scansionate vengono riconosciuti, così l'IA comprende un documento come lo leggerebbe una persona.
Formato proprietario o specifico del settore? Sviluppiamo noi il parser.
Molto più di una ricerca nei documenti
Il RAG classico recupera un passaggio. Un agentic RAG pianifica, cerca più volte, usa strumenti, verifica il proprio risultato e agisce.
Si collega a ciò che usate già
Il vostro RAG non vive su un'isola. Tramite server MCP e connettori dedicati raggiunge i vostri sistemi operativi, in sola lettura o con azioni di scrittura, esattamente come lo definite voi.
Manca qualcosa? Tutto ciò che dispone di un'API, o anche solo di una cartella condivisa, può essere collegato.
Forniamo noi l'hardware
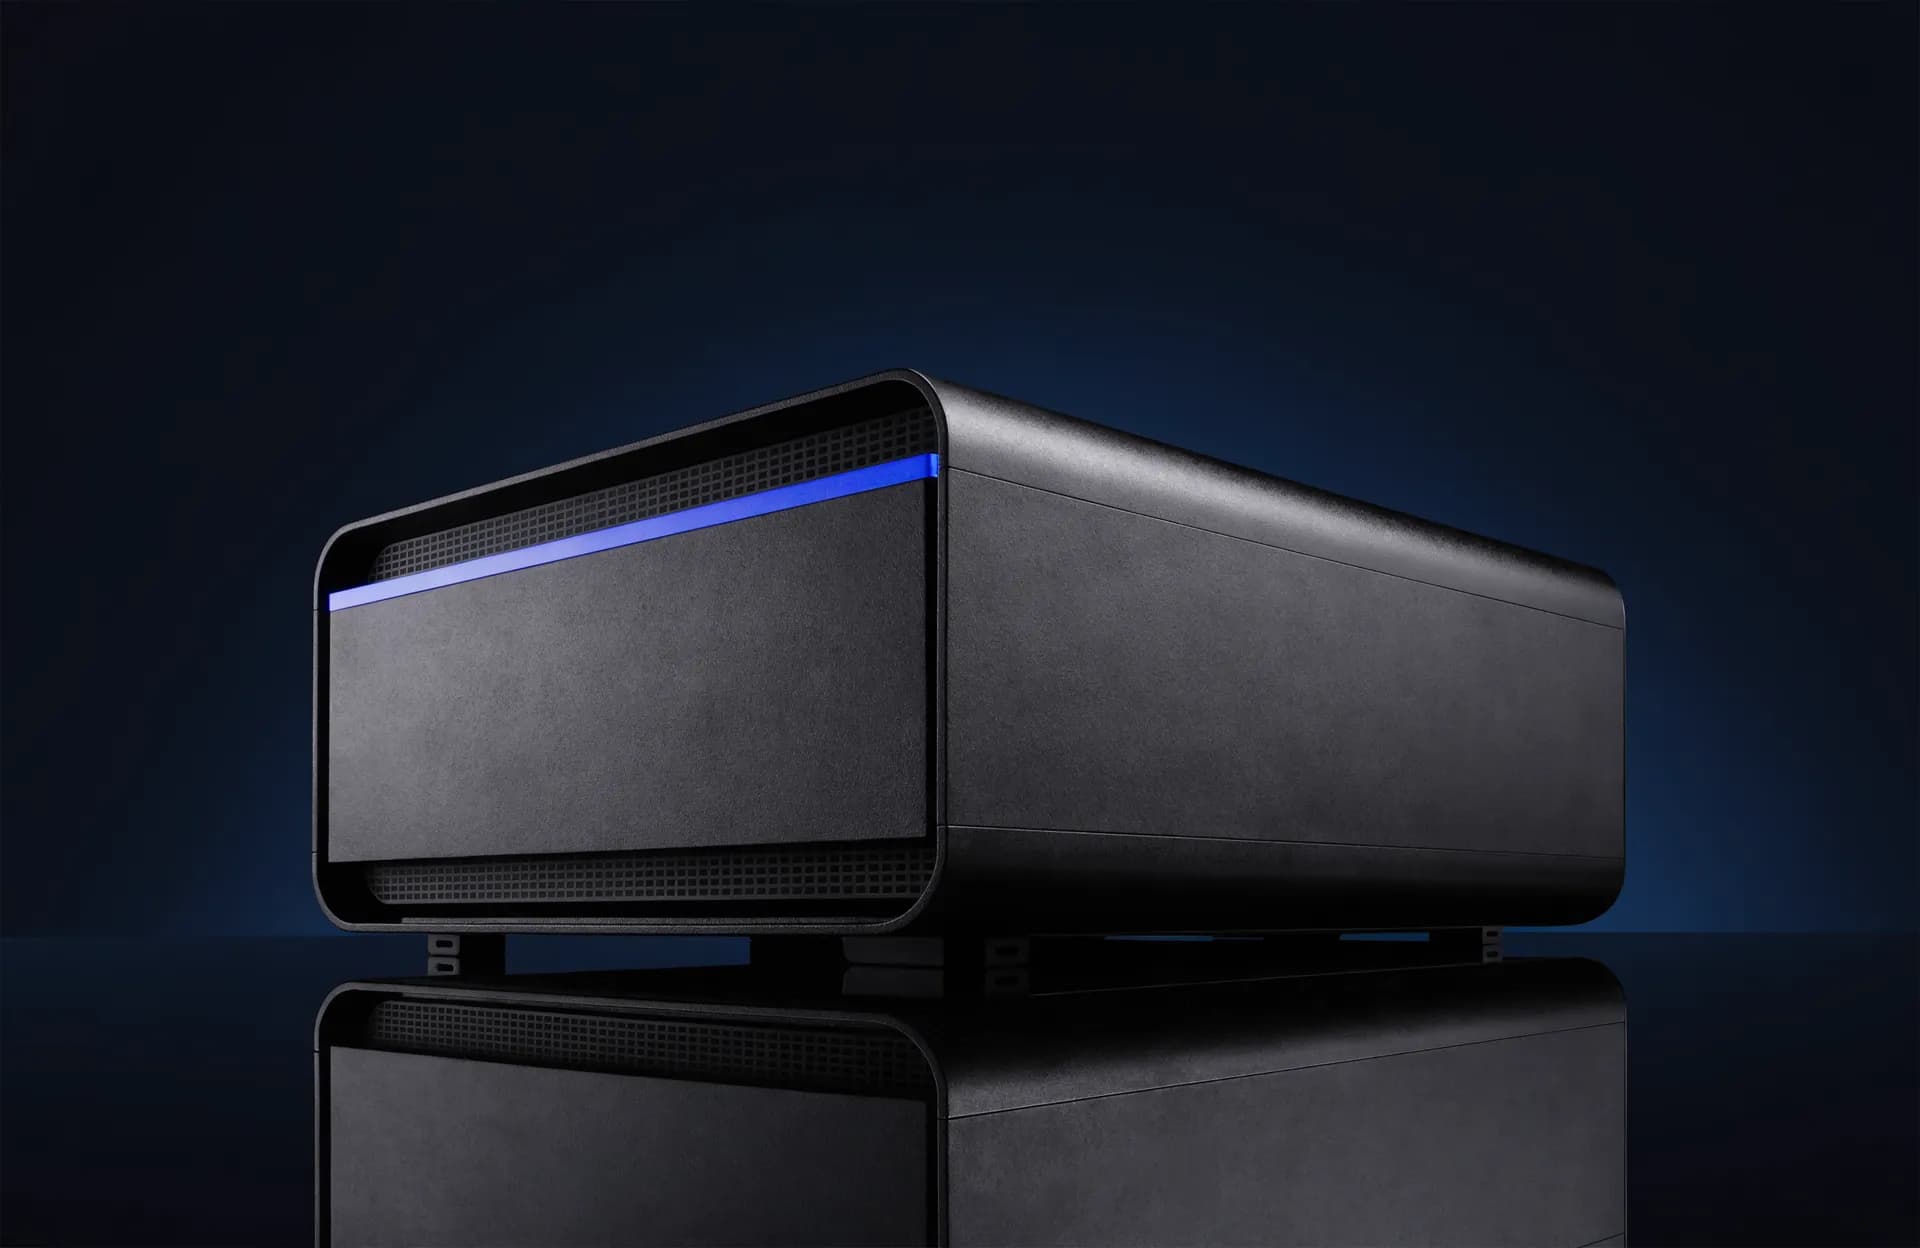
Un RAG locale richiede potenza di calcolo GPU. Non dovete procurarla, dimensionarla né configurarla voi. Forniamo un'appliance pronta all'uso, installata e ottimizzata per il vostro volume di dati e numero di utenti.
Dimensionato su misura
Misuriamo il volume dei vostri documenti, il numero di utenti e i tempi di risposta attesi, quindi definiamo l'esatta configurazione di GPU, RAM e storage, senza alcun sovradimensionamento.
Consegnato e installato
Server rack o appliance workstation, consegnati presso la vostra sede, montati, collegati alla vostra rete e completamente messi in servizio dai nostri ingegneri.
Manutenzione e scalabilità
Monitoraggio, aggiornamenti e upgrade dei modelli inclusi su richiesta. Il team o il volume di dati crescono? Nuovi nodi GPU vengono aggiunti senza tempi di inattività.
- Appliance per team: per reparti fino a ~25 utenti, centinaia di migliaia di pagine
- Server rack aziendale: per l'uso in tutta l'azienda, multi-GPU, terabyte di documenti
- Cluster enterprise: diverse centinaia di utenti simultanei, alta disponibilità, nodi ridondanti
- Variante air-gapped: completamente isolata, per difesa, sanità e infrastrutture critiche
100% GDPR per architettura
Non una promessa nelle condizioni d'uso, ma un dato di fatto tecnico: non esiste alcuna connessione in uscita per elaborare i vostri dati.
Dove AfaRAG fa la differenza
Dal primo contatto al sistema operativo
Workshop di analisi
Analizziamo le vostre fonti di dati, i casi d'uso, i gruppi di utenti e i requisiti di sicurezza, e definiamo obiettivi misurabili.
Proof of concept
Un set di dati limitato su hardware reale. Vedete risposte concrete sui vostri documenti prima di impegnarvi in un rollout.
Hardware e setup
Consegniamo e installiamo l'appliance, colleghiamo le vostre fonti e indicizziamo il vostro archivio, terabyte inclusi.
Agenti e integrazioni
Skill, connessioni MCP, integrazione e-mail e workflow vengono costruiti attorno al modo in cui il vostro team lavora davvero.
Rollout e supporto
Formazione, onboarding, monitoraggio e miglioramento continuo, con un partner austriaco sempre raggiungibile.
Il nostro partner ufficiale
Alan Zettelmann, MBA, MBI, IMBB
Advisor di AfaTech GmbH
Esperto di innovazione aziendale, change management e adozione dell'IA
Alan Zettelmann è un esperto stratega dell'innovazione e della trasformazione aziendale, con una vasta competenza in gestione dell'innovazione, sviluppo organizzativo e change management all'interno di grandi imprese. Attraverso ruoli dirigenziali in organizzazioni internazionali come ANDRITZ Hydro, AVL e Know-Center, ha contribuito allo sviluppo e all'implementazione di strategie di innovazione, nuovi prodotti e iniziative di trasformazione organizzativa. In AfaTech, Alan offre consulenza su innovazione aziendale, change management e adozione efficace dell'IA nelle organizzazioni consolidate. Il suo obiettivo è collegare la tecnologia alle reali esigenze aziendali e garantire che le iniziative di IA siano concrete, scalabili e integrate in modo sostenibile nei flussi di lavoro esistenti.
Domande frequenti
Pronti a valorizzare la vostra conoscenza aziendale ?
Raccontateci i vostri dati e il vostro caso d'uso. Riceverete una valutazione onesta, un concept tecnico e un'offerta concreta, hardware incluso, da un team di ingegneri di Graz, in Austria.