AFARAG
Agentisches lokales RAG für Ihr Unternehmenswissen
Die wertvollsten Daten Ihrer Branche besitzen Sie längst: tausende PDFs, Verträge, Angebote, Berichte, Pläne, E-Mails und Datenbankeinträge. AfaRAG macht aus diesem verstreuten Archiv ein denkendes KI-System, das mit Ihrem eigenen Wissen antwortet, jede Quelle belegt und Ihr Haus niemals verlässt.
Ihr Wissen ist längst vorhanden
Es ist nur nicht nutzbar. Verteilt auf Fileserver, Postfächer, ERP-Systeme und SharePoint, nicht durchsuchbar, nicht dokumentiert und in den Köpfen weniger Kolleginnen und Kollegen eingesperrt.
Suchen statt arbeiten
Mitarbeitende verbringen Stunden pro Woche mit der Jagd nach der richtigen Dokumentversion, dem letzten vergleichbaren Angebot oder einer Spezifikation aus 2019.
Wissen geht zur Tür hinaus
Wenn erfahrene Kolleginnen in Pension gehen oder wechseln, verschwindet jahrzehntelanges Projektwissen mit ihnen, obwohl jedes Dokument noch am Server liegt.
Öffentliche KI ist keine Option
Verträge, personenbezogene Daten, Baupläne und Kalkulationen dürfen niemals in einen US-Cloud-Dienst hochgeladen werden. Die Compliance stoppt das Projekt, bevor es startet.
So funktioniert AfaRAG
Eine vollständige Retrieval-Pipeline plus eine agentische Denkschicht, und jede einzelne Komponente läuft in Ihrer eigenen Infrastruktur.
INDEXIERUNG · läuft im Hintergrund, sobald sich Dokumente ändern
Ihre Daten
Dateien · Mail · ERP · DMS
AfaRAG verbindet sich mit Ihren bestehenden Systemen und erkennt Änderungen. Nichts wird in die Cloud kopiert.
Lesen & OCR
Layout · Tabellen · Scans
Jedes Dokument wird so gelesen, wie ein Mensch es liest: Überschriften, Tabellen und Seitenzahlen bleiben erhalten, gescannte Seiten laufen durch lokale OCR.
Zerlegen & anreichern
Abschnitte · Seitenstempel
Text wird entlang seiner eigenen Struktur geteilt. Jeder Abschnitt kennt Kapitelpfad, Seite und Ordner, damit auch eine nackte Zahlentabelle weiß, wozu sie gehört.
Einbetten
dichte + dünne Vektoren
Ein mehrsprachiges Embedding-Modell macht aus jedem Abschnitt einen Bedeutungsvektor, daneben wird ein Stichwortvektor für exakte Begriffe und Teilenummern gespeichert.
Entitäten extrahieren
Firmen · Personen · Werte
Firmen, Personen, Projekte, Beträge und Termine werden erkannt, über Schreibweisen hinweg zusammengeführt, und jede Beziehung behält Datei und Seite als Beleg.
Hybrider Index
Vektoren + Stichworte
Ein Vektorspeicher hält dichte und dünne Vektoren für Millionen von Abschnitten, mit Filtern für Projekt, Dokumenttyp, Datum und Zugriffsrechte.
Wissensgraph
Entitäten & Beziehungen
Wer hat mit wem an welchem Projekt gearbeitet, belegt wo. Der Graph beantwortet Beziehungsfragen, an denen reine Textsuche scheitert.
Faktenspeicher
strukturierte Datensätze
Kontakte, Rechnungen, Angebote und Prüfergebnisse liegen als strukturierte Datensätze vor, damit Anzahlen, Summen und Vergleiche berechnet und nicht geraten werden.
Lokale Modelle
alles auf Ihrem GPU-Server
Jedes Modell läuft auf Ihrer eigenen Hardware. Nichts ruft eine externe API auf, und jedes Modell lässt sich tauschen, sobald ein besseres offenes Modell erscheint.
FRAGE → ANTWORT · bei jeder Anfrage, in Sekunden
Frage
Chat · Sprache · API
Fragen Sie in Ihren eigenen Worten und Ihrer Sprache: getippt, gesprochen, mit angehängtem Bild oder aus einem anderen System über die API.
Umformulieren & leiten
Absicht → Werkzeuge
Ein kleines lokales Modell entfernt Smalltalk, korrigiert Namen, macht aus der Frage eine Suchphrase und entscheidet, welche Werkzeuge sie braucht.
Abrufen
bis zu 7 Wege, fusioniert
Semantische Suche, Stichwortsuche, exakte Kennungen, Dateipfade, Graph- und Faktenabfragen laufen parallel. Ihre Ergebnisse werden zu den 100 besten Kandidaten fusioniert.
Neu bewerten & filtern
100 → ~8 Passagen
Ein Cross-Encoder liest Frage und Passage gemeinsam. Schwache Passagen fallen weg, die übrigen werden auf ihre ganze Tabelle oder ihren ganzen Abschnitt erweitert.
Erzeugen
lokales LLM · zitiert Quellen
Das lokale LLM denkt nur über die ausgewählten Passagen nach und schreibt die Antwort in der Sprache der Frage, mit Quelle für jede Aussage.
Prüfen
Zahlen · Namen · Dateien
Jede Zahl, jeder Name und jeder Dateiname der Antwort wird gegen die Quellen geprüft. Was dort nicht steht, wird unter der Antwort markiert.
Antwort + Quellen
seitengenaue Zitate
Sie erhalten die Antwort mit den Dokumenten und Seiten, aus denen sie stammt, einen Klick vom Original entfernt.
↻ Agenten-Schleife: Belege zu dünn? Planen, erneut suchen, Werkzeuge nutzen
Schematischer Überblick: von der Rohdatei zur geprüften Antwort mit Quellenangabe, ohne dass ein einziges Byte Ihr Netzwerk verlässt.
LIVE-DEMO
AfaRAG live erleben
Eine simulierte Sitzung mit den echten Pipeline-Schritten: Der Agent formuliert die Frage um, wählt seine Werkzeuge, sucht, bewertet neu, prüft jede Zahl und jeden Namen gegen die Quellen und schreibt erst dann die Antwort. Rechts leuchtet der Wissensgraph die Entitäten auf, die er dabei berührt.
Wissensgraph
Ziehen Sie die Knoten mit der Maus. Fahren Sie über einen Knoten oder tippen Sie ihn an, um seine Verbindungen und die belegenden Dokumente zu sehen.
Simulation mit fiktiven Daten. Die Laufzeiten sind für die Demo verkürzt.
Jedes Dateiformat, strukturiert oder nicht
Wir extrahieren nicht einfach Text. Layout, Tabellen, Überschriften, Fußnoten, eingebettete Bilder und gescannte Seiten werden erkannt, damit die KI ein Dokument so versteht, wie ein Mensch es liest.
Proprietäres oder branchenspezifisches Format? Wir bauen den passenden Parser.
Weit mehr als Dokumentensuche
Klassisches RAG holt eine Textstelle. Ein agentisches RAG plant, sucht mehrfach, nutzt Werkzeuge, prüft sein eigenes Ergebnis und handelt.
Verbindet sich mit dem, was Sie bereits nutzen
Ihr RAG lebt nicht auf einer Insel. Über MCP-Server und dedizierte Konnektoren erreicht es Ihre operativen Systeme, nur lesend oder mit Schreibaktionen, genau wie Sie es festlegen.
Etwas nicht dabei? Alles mit einer API, oder auch nur einer Dateifreigabe, lässt sich anbinden.
Die Hardware liefern wir
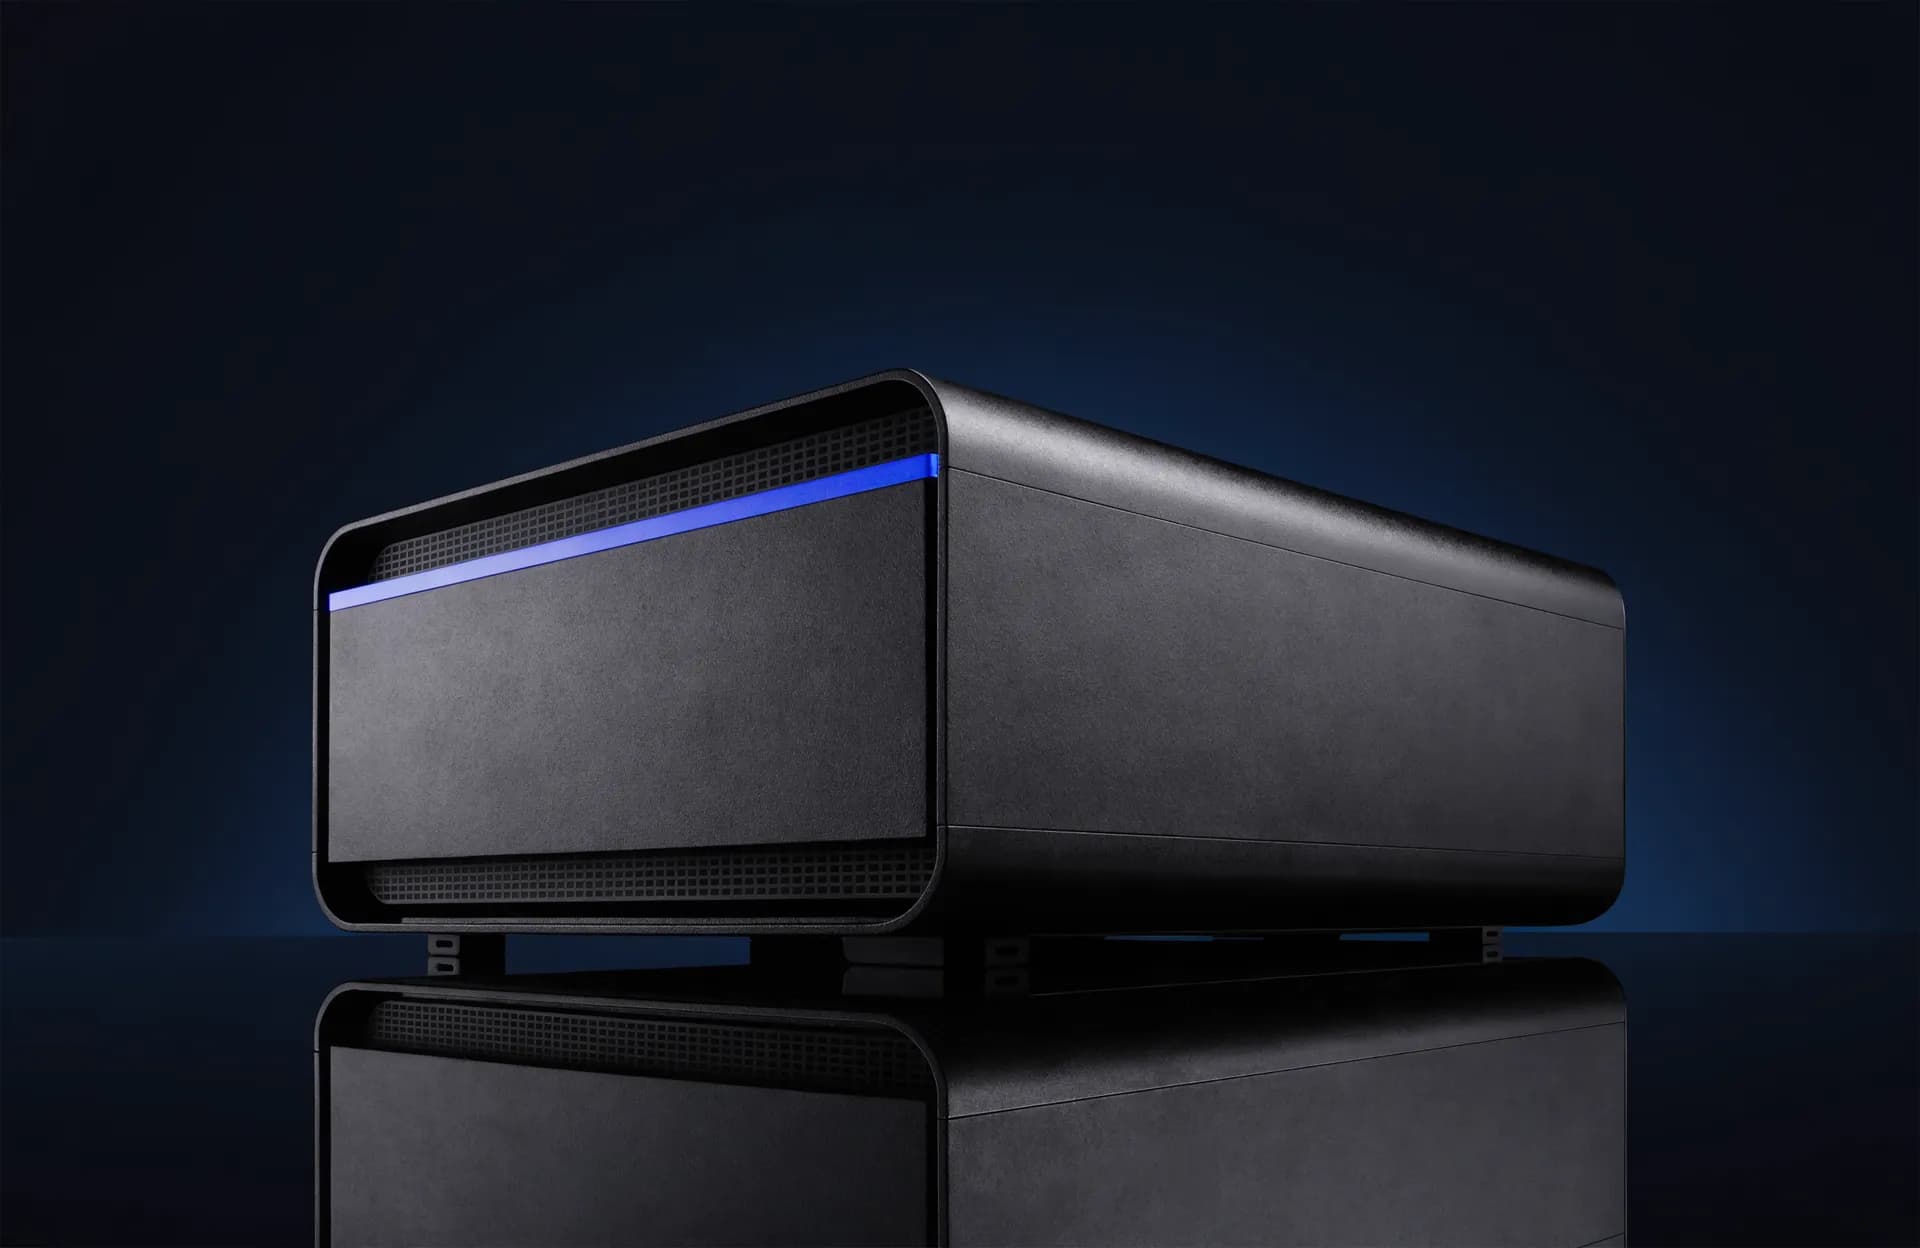
Ein lokales RAG braucht GPU-Rechenleistung. Sie müssen sie weder beschaffen noch dimensionieren oder konfigurieren. Wir liefern eine betriebsfertige Appliance, installiert und auf Ihr Datenvolumen und Ihre Nutzerzahl abgestimmt.
Passgenau dimensioniert
Wir erheben Ihr Dokumentenvolumen, die Nutzerzahl und Ihre Erwartung an Antwortzeiten und spezifizieren dann exakt GPU, RAM und Storage, ohne Überdimensionierung.
Geliefert & installiert
Rack-Server oder Workstation-Appliance, zu Ihnen geliefert, montiert, ans Netzwerk angebunden und von unseren Technikern vollständig in Betrieb genommen.
Gewartet & skalierbar
Monitoring, Updates und Modell-Upgrades auf Wunsch inklusive. Wächst Team oder Datenmenge? Zusätzliche GPU-Knoten kommen ohne Ausfallzeit dazu.
- Team-Appliance: für Abteilungen bis ca. 25 Nutzer, hunderttausende Seiten
- Business-Rack-Server: für den unternehmensweiten Einsatz, Multi-GPU, Terabytes an Dokumenten
- Enterprise-Cluster: mehrere hundert gleichzeitige Nutzer, Hochverfügbarkeit, redundante Knoten
- Air-Gap-Variante: vollständig isoliert, für Verteidigung, Gesundheitswesen und kritische Infrastruktur
100 % DSGVO per Architektur
Kein Versprechen in den AGB, sondern eine technische Tatsache: es existiert schlicht keine ausgehende Verbindung, über die Ihre Daten abfließen könnten.
Wo sich AfaRAG rechnet
Vom Erstgespräch zum laufenden System
Discovery-Workshop
Wir analysieren Ihre Datenquellen, Anwendungsfälle, Nutzergruppen und Sicherheitsanforderungen, und definieren messbare Ziele.
Proof of Concept
Ein begrenzter Datenbestand auf echter Hardware. Sie sehen reale Antworten auf Ihren eigenen Dokumenten, bevor Sie sich für einen Rollout entscheiden.
Hardware & Aufbau
Wir liefern und installieren die Appliance, binden Ihre Quellen an und indizieren Ihr Archiv, Terabytes inklusive.
Agenten & Integrationen
Skills, MCP-Anbindungen, E-Mail-Integration und Workflows entstehen entlang der tatsächlichen Arbeitsweise Ihres Teams.
Rollout & Support
Schulung, Onboarding, Monitoring und laufende Verbesserung, mit einem österreichischen Partner, den Sie anrufen können.
Unser offizieller Partner
Alan Zettelmann, MBA, MBI, IMBB
Berater der AfaTech GmbH
Experte für Corporate Innovation, Change Management und KI-Adoption
Alan Zettelmann ist ein erfahrener Stratege für Corporate Innovation und Transformation mit umfassender Expertise in Innovationsmanagement, Organisationsentwicklung und Change Management in großen Unternehmen. In Führungspositionen bei internationalen Organisationen wie ANDRITZ Hydro, AVL und Know-Center war er an der Entwicklung und Umsetzung von Innovationsstrategien, neuen Produkten und organisatorischen Transformationsinitiativen beteiligt. Bei AfaTech berät Alan zu Corporate Innovation, Change Management und der erfolgreichen Einführung von KI in etablierten Organisationen. Sein Fokus liegt darauf, Technologie mit konkreten Geschäftsanforderungen zu verbinden und sicherzustellen, dass KI-Initiativen praxisnah, skalierbar und nachhaltig in bestehende Arbeitsprozesse integriert werden.
Häufige Fragen
Bereit, Ihr Unternehmenswissen zu erschließen?
Erzählen Sie uns von Ihren Daten und Ihrem Anwendungsfall. Sie erhalten eine ehrliche Einschätzung, ein technisches Konzept und ein konkretes Angebot inklusive Hardware, von einem Engineering-Team aus Graz.